Нейросети рисуют видео уже несколько лет, но пока это кино: красивые кадры, до которых не дотянуться. Главный тренд года — world models, генеративные модели мира, где картинка не проигрывается с плёнки, а пересчитывается заново на каждый ваш шаг. Google DeepMind показала Genie 3: среду, которая в реальном времени выдаёт 720p, помнит, что было у вас за спиной, и по текстовой команде устраивает грозу. Это уже не видеогенерация, а заявка на симулятор реальности. Чем такие модели отличаются от видеогенераторов, что им светит в игровых движках и робототехнике — и где они упираются в счёт за электричество и галлюцинации физики.
Видеогенератор — пассажир. Он один раз проехал маршрут, и всё: с другим водителем поездка не повторится. World model — водитель. Каждый её кадр — прогноз следующего мгновения мира с учётом того, что делает пользователь. Нажали «вперёд» — мир просчитан с новой позиции. Обернулись — за спиной обязано лежать то же, что минуту назад. Задача другого сорта: не «нарисовать красиво», а удерживать состояние мира, не дав ему рассыпаться.
Заняло это года два-три. Сначала Google показала GameNGen — модель, которая внутри себя запускала классический DOOM и выдавала порядка двадцати кадров в секунду. Стартап Decart выпустил Oasis, «Minecraft из нейросети»: в браузере играбельно, но при резких поворотах картинка предсказуемо мылилась — мир переплавлялся прямо на глазах. Потом Genie 2 от DeepMind собирала играбельные 3D-сцены из одной картинки. Шаг за шагом зазор между «видео» и «местом, в котором можно находиться» сужался.
Genie 3 — первая система, где интерактивность и картинка наконец сошлись в реальном времени: 720p при 24 кадрах в секунду, минуты стабильного мира и — главное — навигационная память. Ранние модели теряли себя, стоило отвернуться. Здесь сцена остаётся согласованной, а события добавляются текстом: пусть пойдёт дождь, пусть выйдет прохожий. DeepMind прямо называет world models одним из путей к общему ИИ, и логика в этом есть. Как ожидают исследователи, модель, которая верно предсказывает мир, обязана понимать физику лучше, чем языковая.
Отдельная тема — звук. Видеогенераторы уже освоили нативное аудио: Veo 3 от Google рисует кадр сразу со звуком. Для интерактивных миров продолжение напрашивается само: шаги, эхо в пещере, скрип металла должны быть частью состояния мира, а не наложенным сверху саундтреком. Судя по имеющимся данным, разработчики уже двигаются туда — именно здесь и развернётся ближайшая конкуренция.
Похоронить Unity и Unreal хочется, но преждевременно. Движок — это точность: физика по формулам, уровни, которые можно править, предсказуемый рендер. Нейромир — вероятностный: «поправить вертекс» в нём не выйдет, а правила физики держатся на статистической привычке, а не на законе. Поэтому в играх world models сначала появятся не вместо движков, а рядом: генератор уровней по наброску, симулятор поведения NPC, инструмент для прототипов.
Microsoft идёт ровно этим путём. Её модель Muse обучена на записях геймплея студии Ninja Theory, а Xbox присматривается к применениям — от быстрого прототипирования до «консервации» старых игр, когда поведение классики восстанавливается нейросетью, а не исходным кодом. Дальше маячит стриминг: облако генерирует игру прямо под игрока, без локального билда. Но это уже другой рынок, на котором платформодержатели рискуют потерять контроль над железом и дистрибуцией.
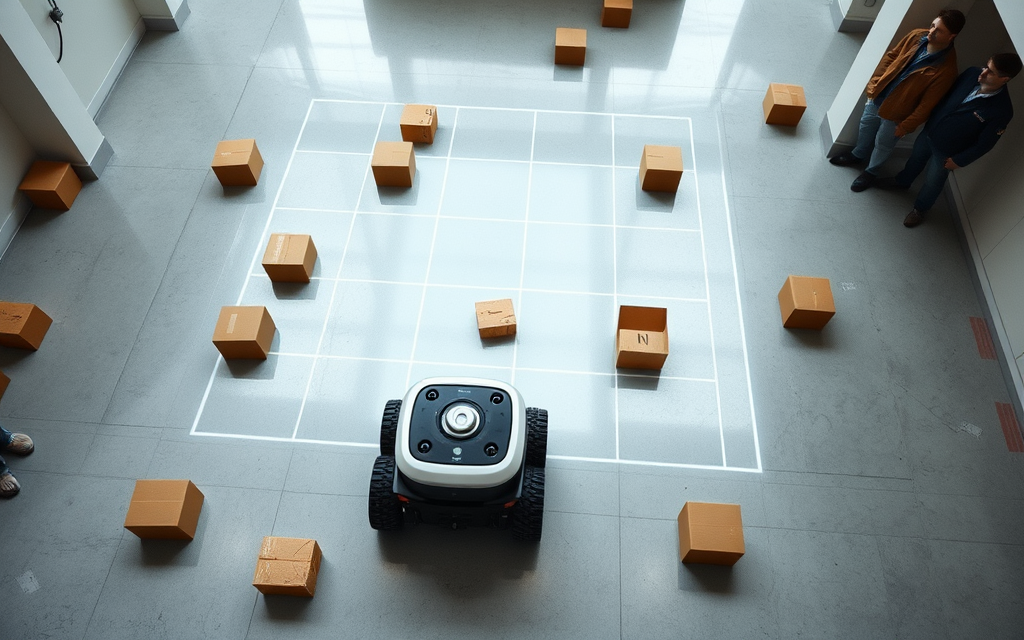
Самая большая ставка — не игры, а роботы. Учить машину на реальном железе дорого и медленно, а классические симуляторы требуют вручную строить каждую сцену. World model снимает это ограничение: она штампует бесконечные вариации среды — другой свет, другой пол, редкие и опасные ситуации, которые в жизни не нарепетируешь. DeepMind уже тренирует агентов прямо внутри миров Genie 3, NVIDIA продвигает семейство моделей Cosmos как «базовые модели мира» для физического ИИ, а лаборатория World Labs Фей-Фей Ли учится собирать трёхмерные сцены из фотографий.
Логика железная: робот должен увидеть тысячу версий мира, прежде чем коснуться хотя бы одной настоящей.
С интерактивными нейромирами у нас, если верить открытым источникам, тишина: публичных систем класса Genie не показали ни Сбер, ни Яндекс, ни научные институты. Ставка сделана на соседние этажи. Видеогенерация есть: Kandinsky у Сбера, YandexART у Яндекса (доступен в «Шедевруме»). Мультимодальные модели растут вокруг GigaChat. Исследования идут в AIRI, ИСП РАН, МФТИ и Сколтехе. В робототехнике Яндекс возит курьерских роботов и развивает беспилотный транспорт, Сбер, по сообщениям СМИ, показывал прототип робота на базе GigaChat, Promobot выпускает сервисные машины.
Главное ограничение — железо. Обучение world models, как ожидают, требует тысяч ускорителей, доступ к которым осложнён; сверху добавляется возможный дефицит уникальных данных вроде записей геймплея. Перспективы скромнее и приземлённее: цифровые двойники городов и заводов, тренажёры для беспилотников и роботов, образовательные симуляторы. Госпрограммы по ИИ и цифровой экономике рамку задают, но прорыв в этой нише потребует концентрации ресурсов федерального масштаба.
World models — это пари: реальность достаточно закономерна, чтобы предсказывать её кадр за кадром и звук за звуком. Пока пари буксует о два обстоятельства. Генерация в реальном времени стоит дороже классического рендера, а физика в нейросети — привычка, а не закон, поэтому миры периодически плывут: предметы меняются на глазах, траектории нарушаются. Но направление сомнений не вызывает. Звук, судя по имеющимся данным, уже доходит и до интерактивных миров; следом — долговременная память и управление событиями текстом. Решатся цена вычислений и стабильность физики — и интерактивная нейросреда заберёт у движков прототипирование, у киностудий постановку кадров, у робототехники полигон. Не завтра и не бесплатно. Но это уже не футурология — это дорожная карта.